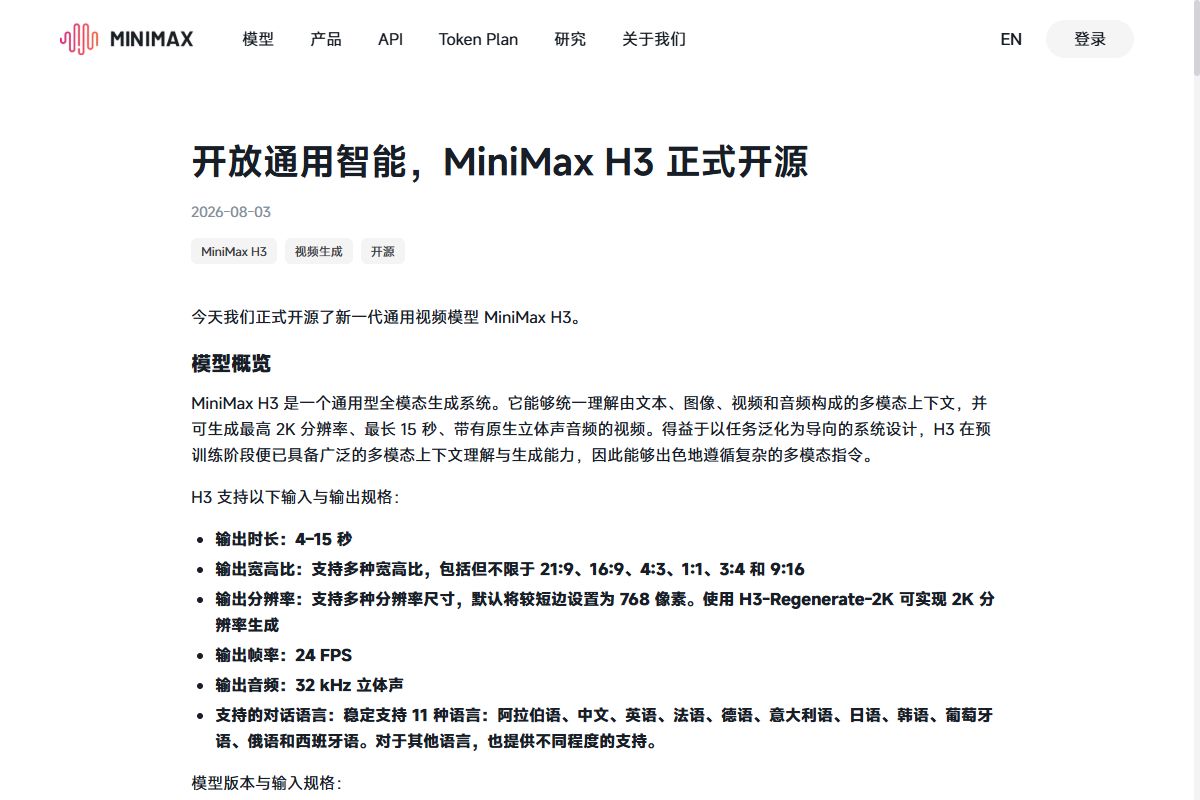
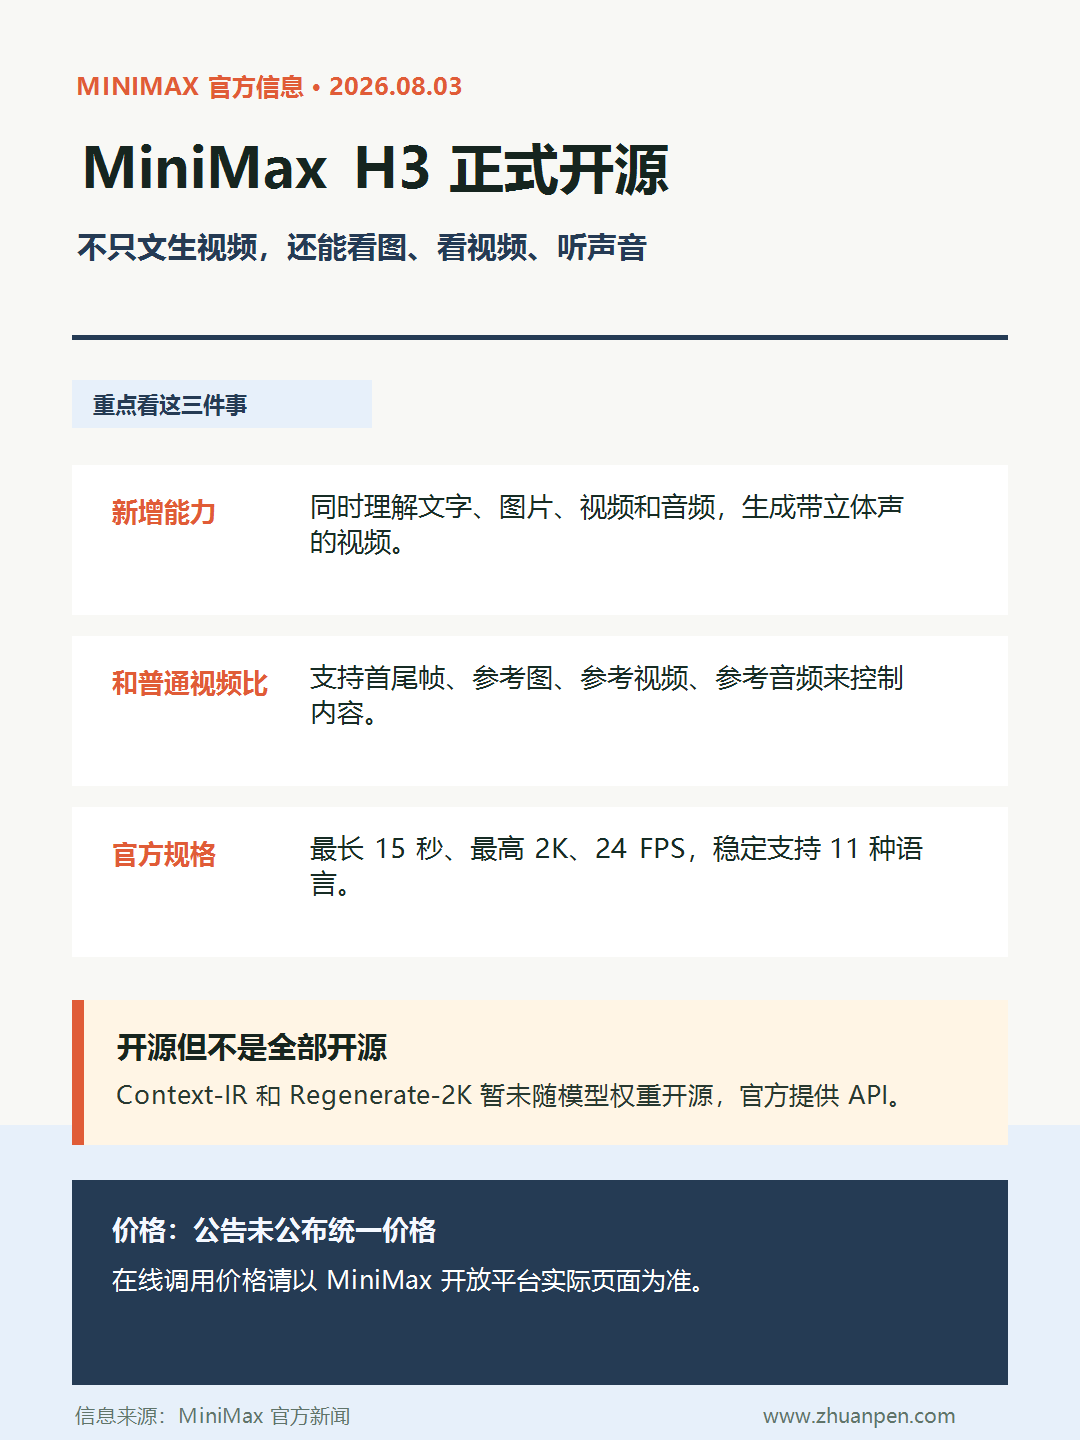
MiniMax 把新一代视频模型 H3 开源了。这次的重点,不只是“文字生成视频”,而是让模型同时理解文字、图片、视频和音频,再生成带立体声音频的视频。
官方给出的规格是:视频最长 15 秒,最高支持 2K 分辨率,24 FPS,输出 32 kHz 立体声,还稳定支持 11 种语言。
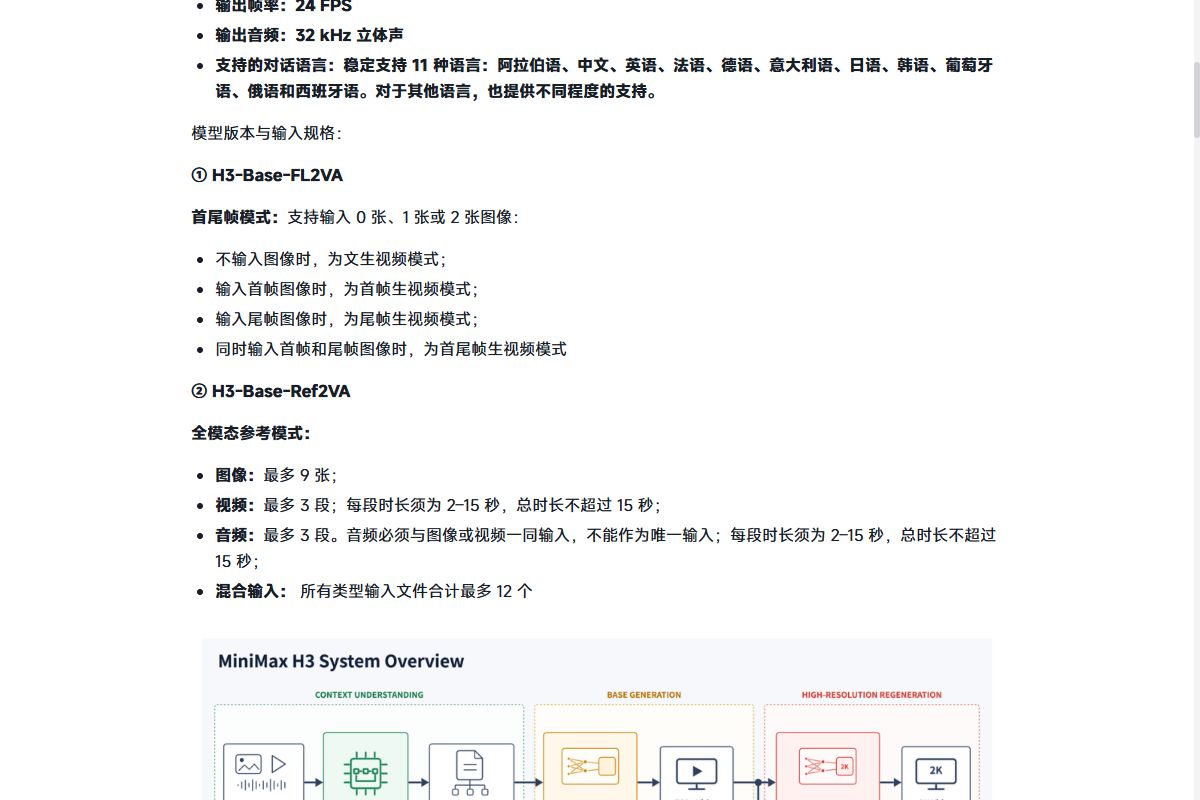
和普通文生视频的区别很直白:你可以给它首帧和尾帧,也可以给参考图、参考视频和参考音频,让它保留人物、场景、动作,甚至参考声音来生成新的对白和嘴型。
它还支持多种输入方式:最多 9 张参考图、3 段参考视频和 3 段音频,所有输入合计最多 12 个文件。
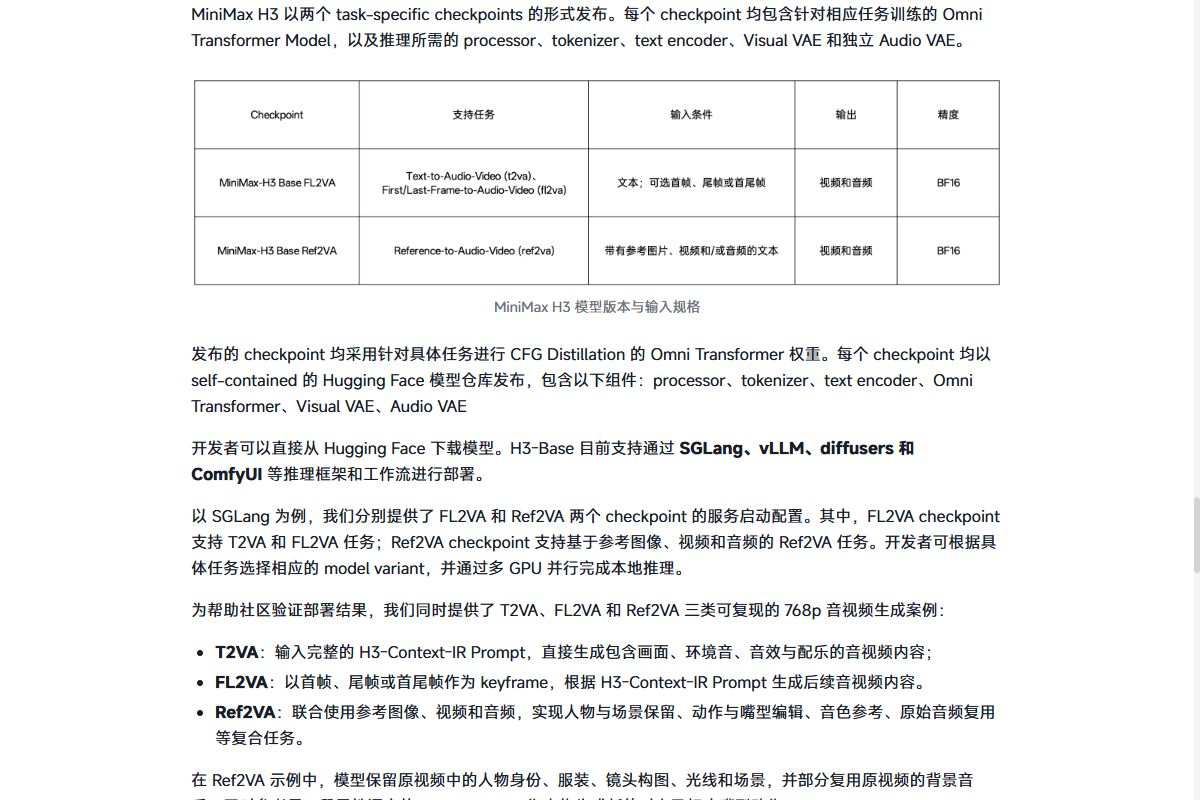
不过要注意,H3-Context-IR 和 H3-Regenerate-2K 这两个官方工作流模块目前没有一起开源,官方提供 API 来复现完整 2K 流程。模型采用 MiniMax H3 Community License,部署可以走 Hugging Face、魔搭、SGLang、vLLM、diffusers 或 ComfyUI。
价格方面,这篇开源公告没有公布统一价格,想在线调用要以 MiniMax 开放平台实际页面为准。
一句话:MiniMax H3 更像一套“能看多种素材、还能生成带声音视频”的全模态视频系统,而不是单纯的文字转视频模型。
来源:https://www.minimaxi.com/news/minimax-h3-open-source